AstaBrief: una rassegna scientifica che il laboratorio può preparare in casa
Ai2 ha reso disponibile un modello per rapporti con citazioni. Può aiutare a orientarsi, ma non sostituisce la lettura degli studi originali.
NEUDYNE / SIGNAL
Novità di scienza e tecnologia, intelligenza artificiale, biologia e nanotecnologie. Anche audio, video, HiFi e tecnica per il palco — con fonti originali e una distinzione chiara fra promesse e risultati verificati.
Come utilizziamo le fonti
Ai2 ha reso disponibile un modello per rapporti con citazioni. Può aiutare a orientarsi, ma non sostituisce la lettura degli studi originali.
Open TTS Leaderboard aiuta a confrontare la sintesi vocale. Pochi errori non significano automaticamente una voce gradevole o un buon ceco.
Il modello NVIDIA usa esempi con risultati noti per stimare altre righe. Un'opportunità interessante per i dati aziendali, non una garanzia di decisioni corrette.
OpenAI avvia la distribuzione di assistenti per attività continuative. Per i lettori europei conta il piano: il solo abbonamento Pro non è ancora sufficiente nella loro regione.
Una proteina progettata artificialmente potrebbe conservare informazioni sulla propria origine? Il nuovo studio offre una prima risposta tecnica, non una garanzia di sicurezza biologica.
H Company ha pubblicato i pesi di due modelli per controllare il software. È interessante il passaggio fra interfacce, ma le licenze sono diverse e le promesse di prestazioni arrivano dal produttore.
OpenAI ha rilasciato un modello per codice, documenti e attività in più fasi. È disponibile in Work, Codex e tramite API, ma non ancora nella normale Chat; gran parte dei dati sulle prestazioni proviene dal produttore.
Google ha presentato un modello per attività prolungate e difesa informatica. L'accesso iniziale è limitato a gruppi di sicurezza selezionati; utenti comuni e molti sviluppatori non possono ancora verificarne le prestazioni.
Anthropic ha lanciato Sonnet 5.5 per programmazione e documenti. Promette risposte più rapide e un costo inferiore per attività, ma i dati sulle prestazioni provengono soprattutto dai test dell'azienda.

Il nuovo modello di SpaceXAI è disponibile tramite API e Cursor. Il produttore segnala risultati migliori nei lavori di programmazione prolungati, ma i confronti pubblicati non dimostrano un vantaggio in ogni applicazione.
OpenAI ha rilasciato due modelli per compiti complessi e di routine. I prezzi delle API scendono, ma i progressi promessi nell'affidabilità si basano ancora soprattutto sui test dell'azienda.
Anthropic ha rilasciato un modello con prezzi per token più bassi e, secondo l'azienda, prestazioni migliori nella programmazione e nell'uso del computer. I risultati vanno letti insieme alla metodologia e alle limitazioni di accesso.
xAI presenta una nuova versione del riconoscimento vocale. Gli sviluppatori devono verificare anche quale versione usano davvero le loro applicazioni.
Il codice aperto propone calcoli più efficienti. I vantaggi per il singolo laboratorio devono essere verificati.
Il modello svizzero aperto raggiunge gli utenti dell’assistente Proton. La novità è l’integrazione, non il rilascio originario del modello.
Valutare gli agenti significa anche capire come sbagliano.
Il nuovo programma invita i laboratori a conciliare utilità e supervisione.
I nuovi modelli possono continuare a parlare mentre svolgono altri passaggi.
Il progetto separa il lavoro dell’agente dal controllo delle autorizzazioni.
Mozilla aggiunge un modello alla beta dell’assistente ed estende l’accesso alla Francia.
I responsabili della sicurezza devono collegare le decisioni di un agente ai suoi accessi.

Per gli sviluppatori, la motivazione originale può valere più di un altro breve riepilogo del progetto.
ProteinTalks suggerisce come dare priorità agli esperimenti. Non è un medico dentro un computer.
Granite PatchTST-FM-r2 si può provare sui propri dati. Oltre a una singola previsione, fornisce una distribuzione dei possibili risultati.
Un assistente sicuro si riconosce dalle risposte, ma anche dai limiti di ciò a cui può accedere.
L’aspetto interessante non è un altro chatbot, ma riprendere un compito incompleto senza spiegare tutto da capo.
Una conversazione fluida può essere utile. Da sola non garantisce che la richiesta sia stata capita correttamente.
OpenAI ha avviato la distribuzione di una nuova generazione del modello per immagini.
Il risultato matematico attende una valutazione indipendente; non è il rilascio di un nuovo modello.
La banca dati aiuta a scegliere varianti da verificare, non a formulare diagnosi.

Il modello collega attività genica e segnalazione; le prove riguardano cellule ed embrioni di topo.
I modelli aperti uniscono entrambi gli ingressi in una rete. Le prove di prestazione provengono per ora dagli sviluppatori.
La nuova modalità carica le parti pertinenti in base alla domanda. I risparmi vanno misurati sul lavoro concreto.
Google amplia gli strumenti per creare video. Una risoluzione maggiore, da sola, non garantisce immagini fedeli.
Un esperimento aziendale sostiene l’automazione di parte della ricerca sulla sicurezza, senza dimostrare che la sicurezza dell’IA sia risolta.
Un nuovo rapporto interno distingue il volume del lavoro automatizzato dal progresso scientifico.
Un sistema di agenti ha prodotto in undici giorni la prima formalizzazione completa in Lean del celebre teorema. Non è una nuova dimostrazione matematica, ma un'enorme codifica verificabile di un percorso già noto.
OpenAI ha avviato un rilascio limitato del nuovo modello per lavoro agentico, programmazione e uso del computer. Le valutazioni interne mostrano forti progressi, ma la scheda di sistema segnala anche una minore monitorabilità del ragionamento e il livello cyber più alto finora raggiunto dall'azienda.
Il nuovo modello di Google integra continuamente dati satellitari e stazioni meteo, affinando la griglia fino a cinque chilometri. La maggiore risoluzione e la valutazione indipendente dal vivo non trasformano però una previsione in certezza o allerta ufficiale.
Anthropic ha rilasciato Fable 5.1, disponibile in generale, e Mythos 5.1, riservato, basati sullo stesso modello ma con protezioni diverse. Letture della cache meno costose possono ridurre il prezzo degli agenti di lunga durata, mentre i prezzi base dei token non cambiano.
Google ha rilasciato un modello generale veloce e una variante di sicurezza per difensori verificati. I prezzi restano promozionali fino a fine anno, ma le prestazioni superiori nei compiti difficili possono richiedere più passaggi e token.
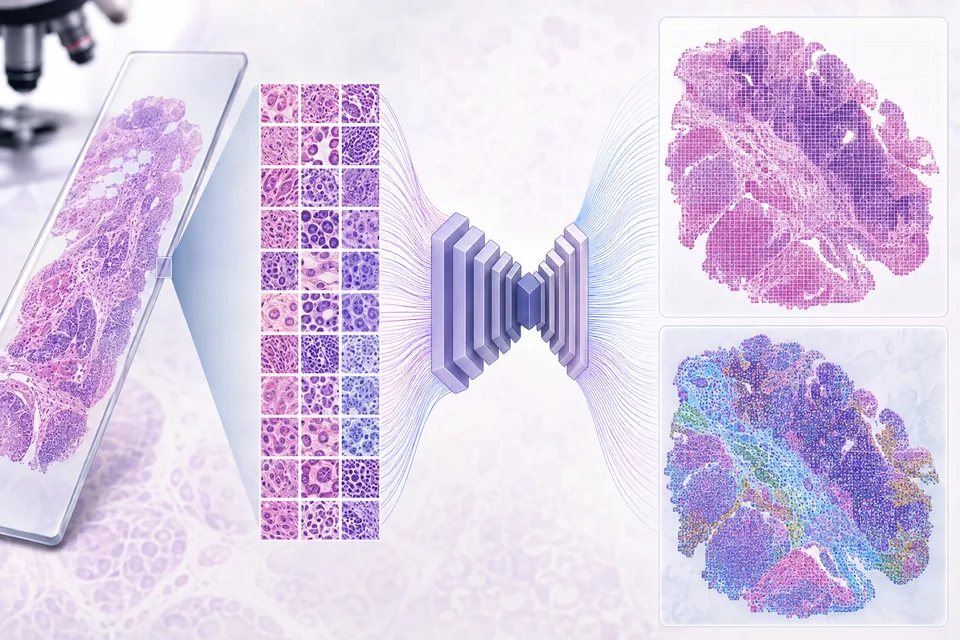
GigaPath‑Flash riduce il costo dell'analisi di interi vetrini istologici e GigaTIME‑Flash stima mappe proteiche spaziali. Sono modelli di ricerca aperti, non strumenti approvati per diagnosi o decisioni terapeutiche.
L'unione tra rappresentazioni linguistiche e processo gaussiano ha eguagliato l'ottimizzazione bayesiana standard con oltre il 40% di prove in meno nei benchmark. Non era un laboratorio gestito autonomamente.
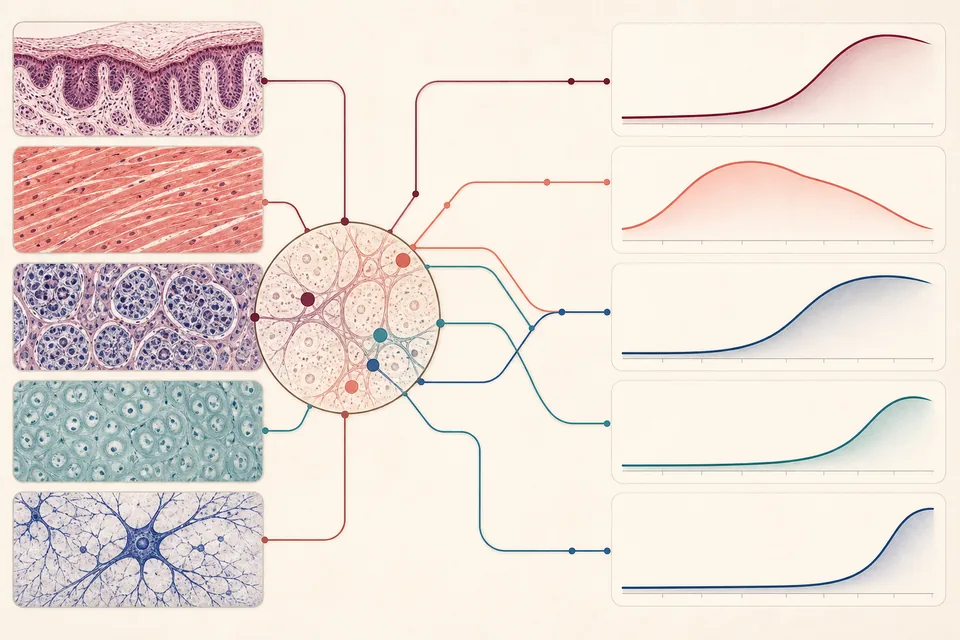
L’analisi di 25.306 campioni post mortem di 970 donatori ha trovato periodi diversi di rapido cambiamento strutturale nei vari tessuti. È una mappa di ricerca, non un test dell’età biologica.
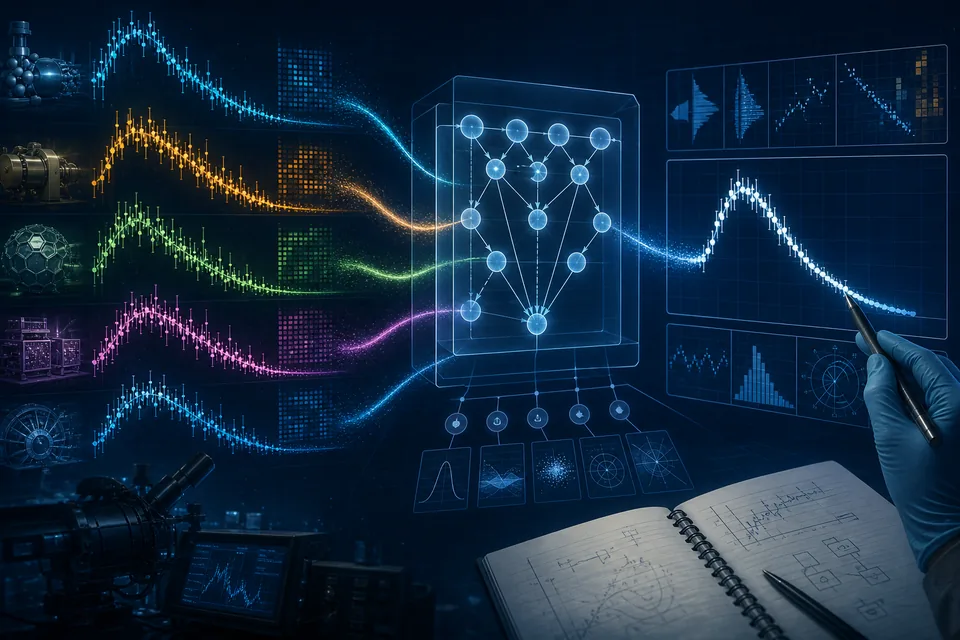
L’apprendimento bayesiano ha collegato le discrepanze nelle misure storiche ai dettagli delle procedure. Gli esperti hanno poi verificato le cause sospette con simulazioni e nuovi esperimenti, riducendo fino a sei volte la dispersione nei dati sul californio-252.
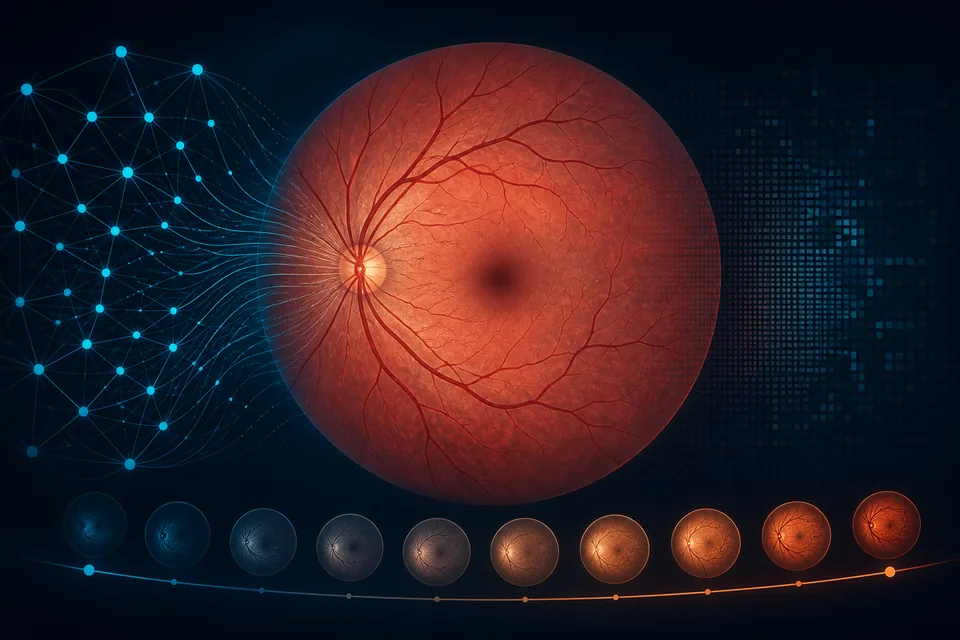
Un modello addestrato su immagini del fondo oculare di 71.343 partecipanti collega il divario d’età retinica a malattie e mortalità. È però un biomarcatore di popolazione, non una diagnosi personale né una prova causale.
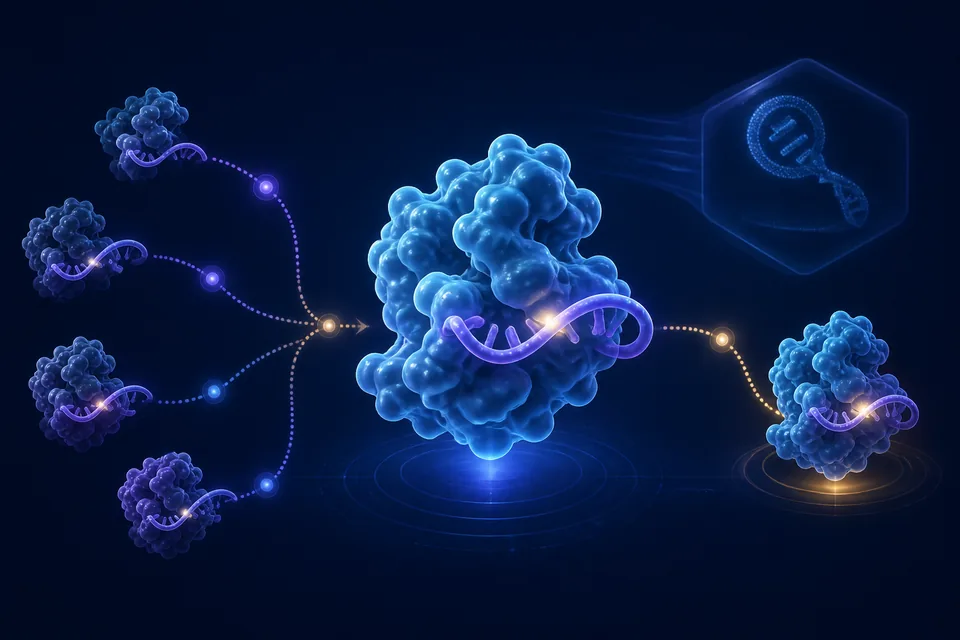
EvoMax combina dati sperimentali scarsi, un modello linguistico delle proteine e stime strutturali. L’editor Fanzor ottenuto è più efficiente in cellule umane ed è stato provato anche su un gene umanizzato nei topi.
Il framework aperto può passare tra stringhe molecolari, grafi e sequenze proteiche. Cerca candidati, ma non dimostra l'efficacia di un farmaco.
VITAL unisce informazioni di sequenza e geometria dell’interfaccia di legame. Nei benchmark ha classificato le interazioni, individuato i contatti e stimato la forza del legame nello stesso sistema.
Otto casi descrivono manutenzione e modernizzazione più rapide. Non sono però un benchmark indipendente e la convalida scientifica rimane la parte difficile.
La ricerca prova a descrivere strutturalmente l’eccesso di ragionamento degli LLM, cercando ripetizioni e cedimenti invece di contare soltanto i token.
NEUDYNE / EDITORIAL
Pubblichiamo sintesi e commenti editoriali originali, non traduzioni integrali di articoli altrui. Colleghiamo sempre l’originale e citiamo autore o editore. Le traduzioni complete vengono pubblicate solo con licenza o autorizzazione esplicita.
Ogni articolo rimanda al lavoro originale. Distinguiamo risultati sperimentali, affermazioni degli autori e nostre prospettive sulle applicazioni pratiche.
Leggi in ceco, inglese, tedesco o italiano. Le discussioni sono condivise tra tutte le lingue.