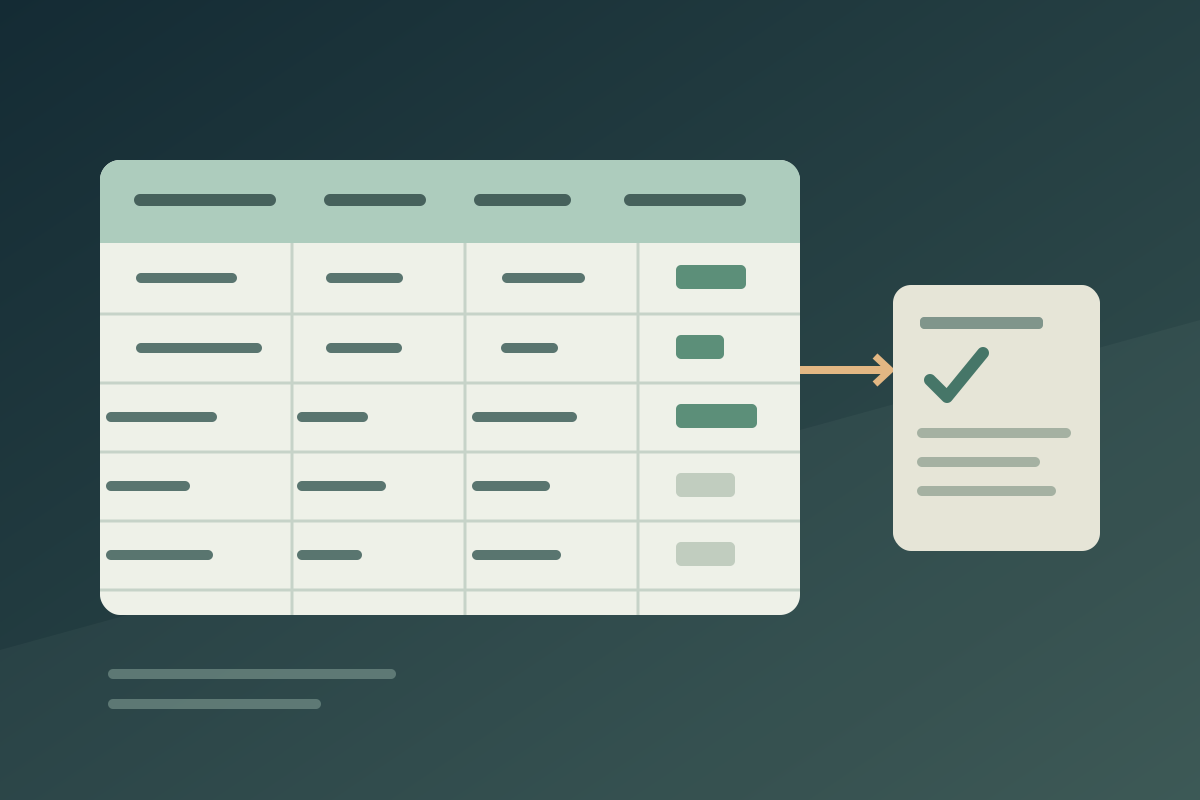
Il 29 settembre NVIDIA ha presentato Kumo Tabular. Il modello preaddestrato riceve una tabella con esempi di cui conosciamo il risultato e stima una categoria o un valore numerico per altre righe. Per il nuovo compito non occorre riaddestrarne i pesi. Gli esempi con risultati noti restano necessari: non si tratta di leggere il futuro da una tabella vuota.
Gli sviluppatori riferiscono un preaddestramento su tabelle artificiali e benchmark propri. Questi non garantiscono un primato confermato indipendentemente. La documentazione comprende anche trasformazioni dei dati in ingresso: «senza nuovo addestramento» non significa «senza preparazione dei dati». I pesi sono sotto OpenMDW 1.1, il codice sotto Apache 2.0; le condizioni sono diverse.
Prospettiva redazionale: un piccolo produttore potrebbe stimare il rischio di difetti dagli ordini passati; un'impresa di manutenzione individuare apparecchi da controllare. Il vantaggio sarebbe verificare più rapidamente se una tabella contiene un segnale utile, non l'infallibilità. Una previsione di associazioni non spiega la causa di un guasto e non dovrebbe fermare autonomamente la produzione.
Prima dell'impiego servono dati di prova separati, mai forniti al modello come esempi, e un confronto con un metodo semplice già in uso. Con registrazioni temporali, verificare anche periodi successivi per evitare fughe di informazioni future. Nel bilancio includere calcolo, falsi allarmi e controllo umano.
Un primo esperimento può iniziare subito con i pesi disponibili. Con dati utilizzabili e risorse tecniche, un pilota ottimistico potrebbe fornire una valutazione in due-otto settimane. È una stima redazionale per una prova limitata, non una promessa di risparmio o di sistema pronto. L'illustrazione mostra una tabella inventata, non un risultato di Kumo.
Apri la discussione con il primo commento.