AstaBrief: eine Literaturrecherche auf der eigenen Infrastruktur
Ai2 hat ein Modell für Berichte mit Quellenangaben veröffentlicht. Es hilft bei der ersten Orientierung, ersetzt aber nicht die Lektüre der Originalstudien.
NEUDYNE / SIGNAL
Neuigkeiten aus Wissenschaft und Technik, künstlicher Intelligenz, Biologie und Nanotechnologie. Dazu Audio, Video, HiFi und Bühnentechnik — mit Originalquellen und einer klaren Trennung zwischen Versprechen und belegten Ergebnissen.
Unser Umgang mit Quellen
Ai2 hat ein Modell für Berichte mit Quellenangaben veröffentlicht. Es hilft bei der ersten Orientierung, ersetzt aber nicht die Lektüre der Originalstudien.
Open TTS Leaderboard erleichtert den Vergleich von Sprachsynthese. Eine geringe Fehlerrate bedeutet noch keine angenehme Stimme oder gutes Tschechisch.
Das NVIDIA-Modell nutzt Beispiele mit bekannten Ergebnissen und schätzt weitere Zeilen. Eine interessante Chance für Unternehmensdaten, keine Garantie für richtige Entscheidungen.
OpenAI stellt schrittweise Assistenten für laufende Aufgaben bereit. Für europäische Leser zählt die Tarifgrenze: Pro allein reicht in ihrer Region bislang nicht aus.
Könnte ein künstlich entworfenes Protein seine Herkunft mitführen? Eine neue Arbeit liefert eine erste technische Antwort, keine Garantie biologischer Sicherheit.
H Company hat die Gewichte zweier Modelle zur Softwaresteuerung veröffentlicht. Der Wechsel zwischen Schnittstellen ist interessant; Lizenzen unterscheiden sich und Leistungsversprechen stammen vom Anbieter.
OpenAI hat ein Modell für Programmierung, Dokumente und mehrstufige Aufgaben veröffentlicht. Es ist in Work, Codex und per API verfügbar, jedoch noch nicht im gewöhnlichen Chat; die Leistungswerte stammen überwiegend vom Anbieter.
Google stellte ein Modell für lange Arbeitsabläufe und Cyberabwehr vor. Zunächst erhalten nur ausgewählte Sicherheitsteams Zugang; normale Nutzer und die meisten Entwickler können die Angaben noch nicht selbst prüfen.
Anthropic hat Sonnet 5.5 für Programmierung und Dokumentenarbeit veröffentlicht. Schnellere Ausgaben und geringere Kosten je Aufgabe werden versprochen; die Leistungszahlen stammen jedoch überwiegend aus Tests des Anbieters.

Das neue Modell von SpaceXAI ist über die API und Cursor verfügbar. Der Anbieter meldet bessere Ergebnisse bei länger dauernder Programmierarbeit; die veröffentlichten Vergleiche beweisen jedoch keinen Vorteil für jeden Einsatz.
OpenAI hat zwei Modelle für anspruchsvolle und routinemäßige Aufgaben veröffentlicht. Die API-Preise sinken; die versprochenen Verbesserungen bei der Zuverlässigkeit beruhen jedoch vor allem auf unternehmenseigenen Tests.
Anthropic hat ein Modell mit niedrigeren Tokenpreisen und laut eigener Aussage besserer Leistung beim Programmieren und bei der Computersteuerung veröffentlicht. Die Testergebnisse müssen zusammen mit Methodik und Zugangsbeschränkungen gelesen werden.
xAI hat eine neue Version der Spracherkennung vorgestellt. Entwickler müssen auch prüfen, welche Version ihre Anwendungen tatsächlich verwenden.
Offener Code soll Berechnungen effizienter machen. Der Nutzen für einzelne Labore muss noch geprüft werden.
Das offene Schweizer Modell erreicht Nutzer des Proton-Assistenten. Neu ist die Integration, nicht die ursprüngliche Veröffentlichung des Modells.
Zur Bewertung von Agenten gehört auch, ihre Fehler zu verstehen.
Das neue Programm stellt Labore vor die Frage, wie Nutzen und Aufsicht zusammenpassen.
Die neuen Modelle können weiterreden, während sie zusätzliche Schritte bearbeiten.
Der Entwurf trennt die Arbeit des Agenten von der Kontrolle seiner Berechtigungen.
Mozilla ergänzt die Beta des Assistenten um ein Modell und erweitert den Zugang auf Frankreich.
Sicherheitsteams müssen die Entscheidungen eines Agenten mit seinen Zugriffsrechten verbinden.

Für Entwickler kann die ursprüngliche Begründung wertvoller sein als eine weitere kurze Projektzusammenfassung.
ProteinTalks könnte helfen, Laborversuche zu priorisieren. Es ist kein Arzt im Computer.
Granite PatchTST-FM-r2 lässt sich mit eigenen Daten testen. Neben einer einzelnen Prognose liefert es eine Verteilung möglicher Ergebnisse.
Ein sicherer Assistent zeichnet sich nicht nur durch Antworten aus, sondern auch durch begrenzte Zugriffsrechte.
Interessant ist nicht das Versprechen eines weiteren Chatbots, sondern die Fortsetzung einer Aufgabe ohne erneute Gesamterklärung.
Ein flüssiges Gespräch kann helfen. Es bedeutet noch nicht, dass der Auftrag richtig verstanden wurde.
OpenAI hat die Einführung einer neuen Generation seines Bildmodells begonnen.
Das mathematische Ergebnis muss unabhängig geprüft werden; ein neues Modell wurde damit nicht veröffentlicht.
Die Forschungsdatenbank hilft bei der Auswahl zu prüfender Varianten, nicht bei Diagnosen.

Das Modell verbindet Genaktivität mit Signalwegen; die Befunde stammen aus Zellen und Mausembryonen.
Offene Modelle verbinden beide Eingaben in einem Netz. Die Leistungsdaten stammen bislang von den Entwicklern.
Der neue Modus lädt relevante Ausschnitte passend zur Frage. Einsparungen müssen am konkreten Einsatz geprüft werden.
Google erweitert seine Werkzeuge zur Videoerstellung. Höhere Auflösung allein garantiert kein originalgetreues Bild.
Ein Unternehmensexperiment unterstützt die Automatisierung eines Teils der Sicherheitsforschung. Es erklärt KI-Sicherheit nicht für gelöst.
Ein neuer interner Bericht trennt den Umfang automatisierter Arbeit vom wissenschaftlichen Fortschritt.
Ein Agentensystem erstellte in elf Tagen die erste vollständige Lean-Formalisierung des berühmten Satzes. Das ist kein neuer mathematischer Beweis, sondern eine außergewöhnlich große maschinenprüfbare Fassung eines bekannten Beweiswegs.
OpenAI hat mit der begrenzten Einführung eines neuen Modells für agentische Arbeit, Programmierung und Computersteuerung begonnen. Eigene Tests zeigen große Sprünge; zugleich beschreibt die Systemkarte eine schlechtere Überwachbarkeit des Denkprozesses und die bisher höchste Cyber-Fähigkeitsstufe des Unternehmens.
Googles neues Modell bindet laufend Satelliten- und Stationsdaten ein und verfeinert das räumliche Raster bis auf fünf Kilometer. Höhere Auflösung und unabhängige Live-Bewertung machen aus einer Prognose dennoch keine Gewissheit oder amtliche Warnung.
Anthropic veröffentlicht den allgemein verfügbaren Fable 5.1 und den beschränkten Mythos 5.1 auf derselben Grundlage, jedoch mit unterschiedlichen Schutzregeln. Günstigere Cache-Lesezugriffe können lange Agentenaufgaben verbilligen; die Grundpreise pro Token bleiben gleich.
Google veröffentlicht ein schnelles Universalmodell und eine Sicherheitsvariante für geprüfte Verteidiger. Bis Jahresende gelten Einführungspreise; höhere Leistung kann bei schwierigen Aufgaben jedoch mehr Schritte und Token erfordern.
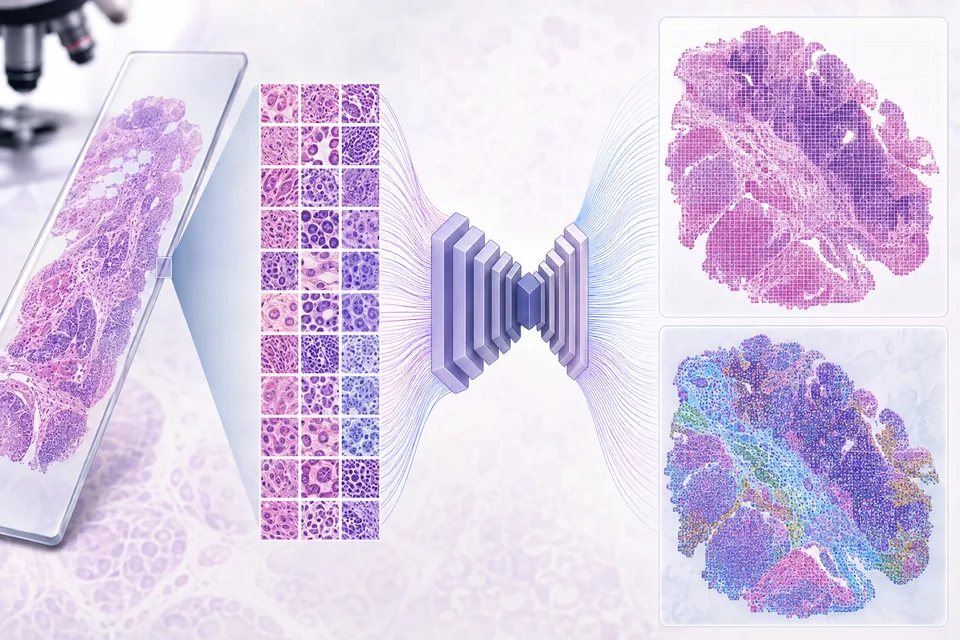
GigaPath‑Flash senkt den Aufwand für ganze Histologiescans, GigaTIME‑Flash schätzt räumliche Proteinkarten. Es sind offene Forschungsmodelle, keine zugelassenen Werkzeuge für Diagnose oder Therapieentscheidungen.
Die Verbindung von Sprachmodell-Repräsentationen mit einem gaußschen Prozess erreichte in Benchmarks die übliche bayessche Optimierung mit über 40 % weniger Versuchen. Es handelte sich nicht um ein selbstständig betriebenes Labor.
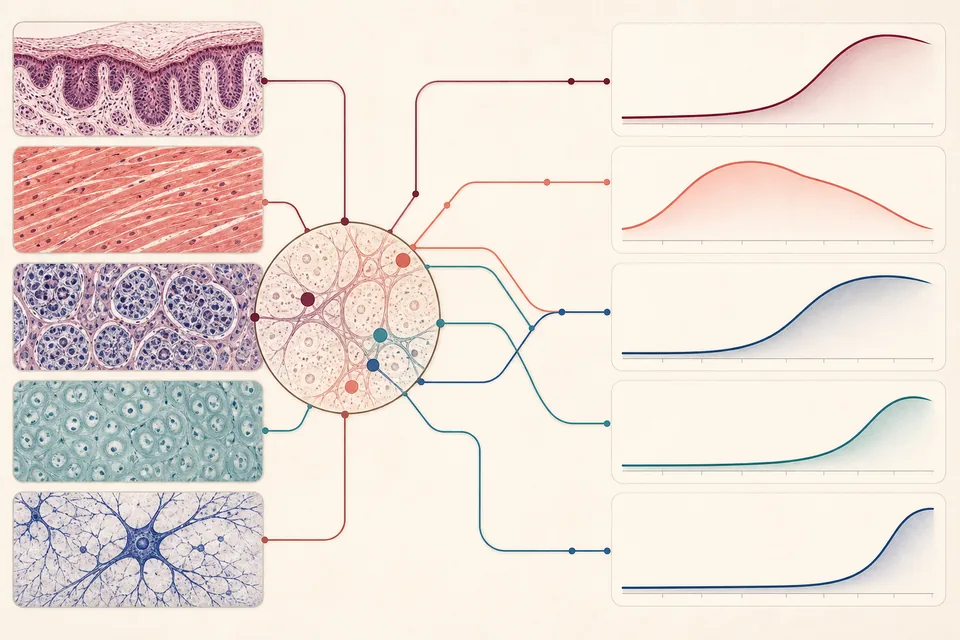
Die Analyse von 25.306 postmortalen Proben von 970 Spendern fand je nach Gewebe verschiedene Phasen schneller Strukturveränderung. Sie ist eine Forschungskarte, kein Test des biologischen Alters.
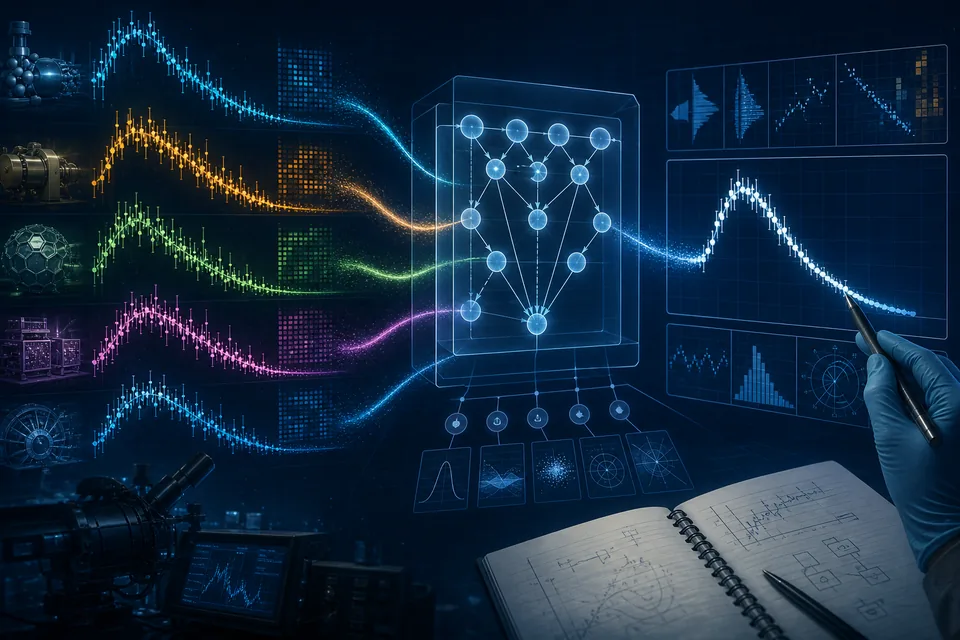
Bayessches maschinelles Lernen verband Unterschiede historischer Messungen mit Details der Versuchsabläufe. Fachleute prüften die Verdachtsmomente durch Simulationen und neue Experimente; die Streuung der Californium-252-Daten sank bis auf ein Sechstel.
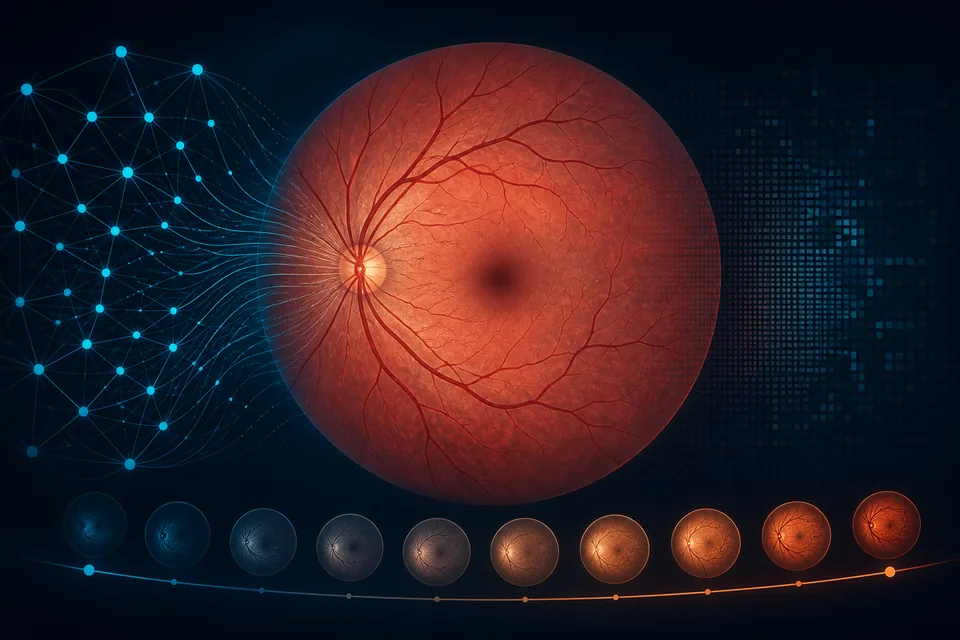
Ein Modell auf Augenhintergrundbildern von 71.343 Teilnehmenden verknüpfte die Netzhaut-Alterslücke mit Krankheiten und Sterblichkeit. Sie ist jedoch ein Populationsmarker, keine persönliche Diagnose und kein Kausalitätsnachweis.
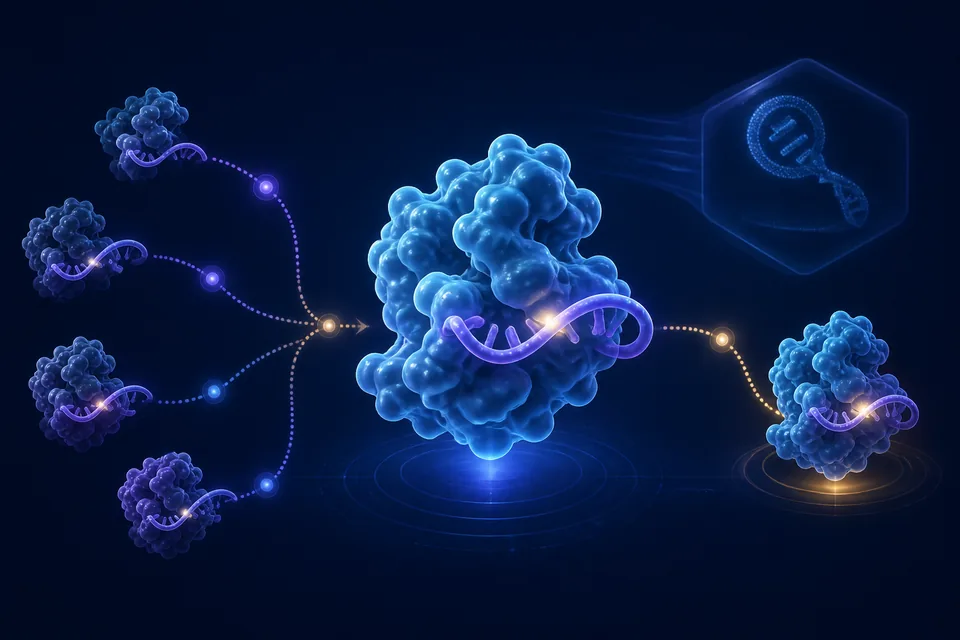
EvoMax verband wenige Versuchsdaten, ein Protein-Sprachmodell und Strukturabschätzungen. Der entwickelte Fanzor-Editor war in menschlichen Zellen aktiver und wurde auch an einem humanisierten Gen in Mäusen getestet.
Das offene System kann zwischen Molekülzeichenketten, Graphen und Proteinsequenzen wechseln. Es sucht Kandidaten, belegt aber kein wirksames Medikament.
VITAL verbindet Sequenzinformationen mit der Geometrie der Bindungsfläche. In Benchmark-Datensätzen klassifizierte das System Interaktionen, kartierte Kontaktstellen und schätzte die Bindungsstärke.
Acht Fallstudien berichten von schnellerer Wartung und Modernisierung. Ein unabhängiger Benchmark sind sie nicht, und die wissenschaftliche Validierung bleibt die schwierigste Aufgabe.
Forschung beschreibt das Überdenken von LLMs strukturell: Entscheidend sind Wiederholung und Zerfall der Argumentation, nicht nur die Tokenzahl.
NEUDYNE / EDITORIAL
Wir veröffentlichen eigene redaktionelle Zusammenfassungen und Einordnungen, keine vollständigen Übersetzungen fremder Artikel. Wir verlinken stets das Original und nennen Autor oder Verlag. Vollständige Übersetzungen erscheinen nur mit Lizenz oder ausdrücklicher Erlaubnis.
Jeder Artikel verlinkt die Originalarbeit. Wir unterscheiden experimentelle Ergebnisse, Aussagen der Autoren und unseren Ausblick auf praktische Anwendungen.
Lesen Sie auf Tschechisch, Englisch, Deutsch oder Italienisch. Die Diskussionen sind sprachübergreifend.